问题背景
现有的方法直接从单目图像中估计3D边界框,或者使用深度预测网络从2D信息中生成用于3D目标检测的输入,而DETR3D的方法直接在3D空间中进行预测。该框架从多个相机图像中提取2D特征,然后使用一组稀疏的3D对象查询来索引这些2D特征,使用相机变换矩阵将3D位置链接到多视图图像。最后,对每个对象查询进行边界框预测,使用集对集损失来衡量真实值与预测值之间的差异。
方法分析
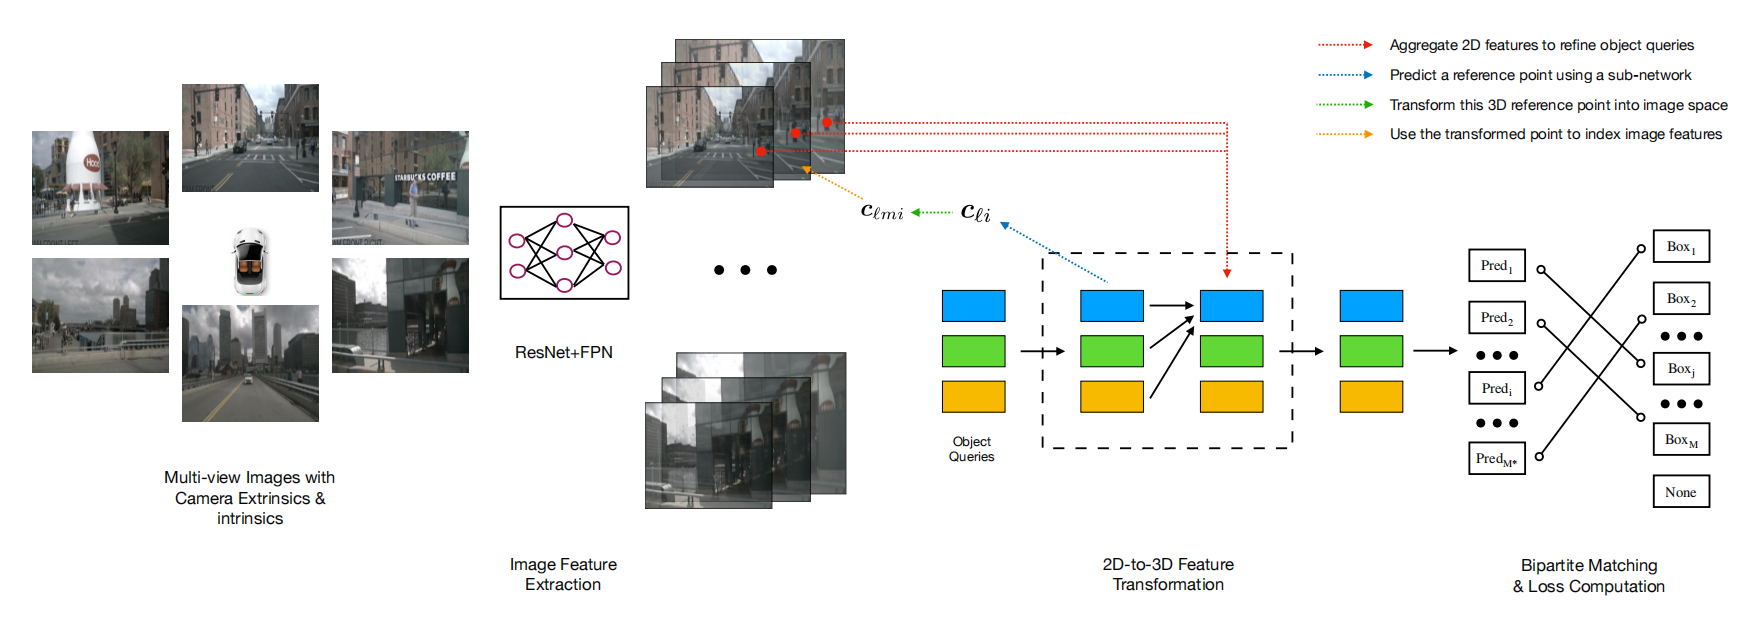
Image Feature Extraction
输入:多视角图像,相机内外参
处理:使用ResNet+FPN提取特征
输出:Camera Feature
在DETR3D框架中,首先使用ResNet和FPN从多个相机视角图像中提取2D特征。
2D to 3D Feature Transformation
- 输入:Camera Feature & Object Queries
- 处理:
- 随机初始化的查询向量
- 提取reference points
- 将3D点投影到图像平面
- 从图像特征中提取相关信息
- 使用2D特征优化3D物体表征
- 输出:Object Feature
DETR3D通过使用一组稀疏的3D对象查询来索引这些2D特征。每个对象查询与一个3D参考点相关联,该参考点被投影到所有相机图像上,通过双线性插值从图像特征中提取信息。这些特征随后通过多头自注意力机制相互交互,优化和细化对象查询,最终生成3D边界框预测。
1. Object Queries and Reference Points
对象查询(Object Query)在DETR和DETR3D中的角色类似于一个先验框或锚点,用于表示和定位目标物体。它们在初始化时是一些随机向量,随着模型的训练和特征提取过程,它们会逐步融合更多的视觉信息,变得更具代表性。
Object Queries (对象查询)
对于每一层,预测M个查询向量,这些向量经过神经网络生成M个三维坐标表示该预测边界框的中心位置。
每层
都有一组对象查询 ,其中 表示第 个对象查询,是一个 维的向量。 这些对象查询通过神经网络
解码为参考点 ,公式如下: 是一个三维坐标,表示第 个边界框的中心位置的假设。
Projection to Camera Images(参考点投影)
对于每一个预测边界框的中心点,先添加一个维度变成齐次坐标,然后通过相机变换矩阵投影到对应的相机上。
将
投影到各个相机图像上,需要使用相机变换矩阵。首先将 转换为齐次坐标 ,公式如下:
这里表示连接操作,即在 后面添加一个维度,使其变成齐次坐标。 使用相机变换矩阵
将 投影到第 个相机图像上,得到 :
2. Feature Extraction
Feature Map Normalization (特征图归一化)
- 将
归一化到 [-1, 1] 的范围,以适应不同分辨率的特征图。
Feature Collection (特征收集)
使用双线性插值从特征图中提取特征
: 双线性插值: 双线性插值是一种从图像中提取像素特征的方法,它基于参考点在图像中的位置来插值得到特征值。
具体公式为:
其中:表示双线性插值操作。 是第 个特征层在第 个相机的特征图。 是第 层的第 个参考点在第 个相机图像中的位置。
双线性插值的具体过程(使用临近的四个像素值来计算目标点的特征值):
确定邻近的四个像素: 假设
的坐标是 ,那么它的邻近四个像素的坐标可能是: - 左上角:
- 右上角:
- 左下角:
- 右下角:
- 左上角:
计算水平和垂直方向的插值: 首先对水平和垂直方向分别进行线性插值:
水平方向插值:
垂直方向插值:
可以得到参考点
在特征图 上的特征值 。
3. Feature Aggregation and Query Update
Heuristics for Valid Points (有效点的启发式方法)
- 参考点不一定在所有相机图像中都可见,需要用启发式方法筛选无效点,定义二值变量
,如果参考点投影到图像平面外,则 ,否则 。
Feature Aggregation (特征聚合)
- 对于每个参考点
,通过聚合来自不同相机和特征层的特征值来计算聚合特征 ,聚合特征 并更新对象查询 ,公式如下:
其中:
是聚合后的特征值。 是二值变量,表示参考点是否在图像平面内。 是一个小数,防止除以零。
4. Bounding Box and Classification
- 对于每个对象查询
,通过两个神经网络 和 分别预测边界框 和类别标签 ,公式如下:
Loss Calculation
- 计算每层的预测结果
和 :
其中
其中
- 匹配预测和真实值
首先,我们需要将预测的边界框和分类标签与真实值进行匹配。设定M个真实值和M个预测值,其中M通常小于M,因此用空值
- 边界框回归损失
对于匹配后的边界框,我们计算L1损失和IoU损失。这些损失衡量预测边界框与真实边界框之间的位置、尺寸和形状的差异。
L1损失:
其中
是匹配对的集合, 是预测边界框, 是真实边界框。 IoU损失:
- 分类损失
分类损失通常使用交叉熵损失来衡量预测的分类标签与真实标签之间的差异。
- 交叉熵损失:
其中是预测分类标签, 是真实分类标签,CE表示交叉熵损失函数。
- 总损失
总损失是边界框回归损失和分类损失的加权和:
其中
结论
DETR3D通过直接在3D空间中进行预测,避免了由于深度预测带来的累积误差问题,简化了检测管道,并提高了效率。核心贡献包括:
- 引入了一种将2D特征提取与3D边界框预测连接的模块,通过几何回投将3D信息无缝地使用到多视角图像中。
- 在不需要NMS的情况下,实现了与现有基于NMS的方法相媲美的性能,显著提高了推理速度。
- 通过在nuScenes数据集上的实验验证,证明了方法的有效性和优越性。
这使得DETR3D成为一种高效、鲁棒且性能优越的3D目标检测方法,为自动驾驶和其他需要高精度3D检测的应用提供了新的解决方案。