原文链接:Exploring Object-Centric Temporal Modeling for Efficient Multi-View 3D Object Detection
1. Introduction
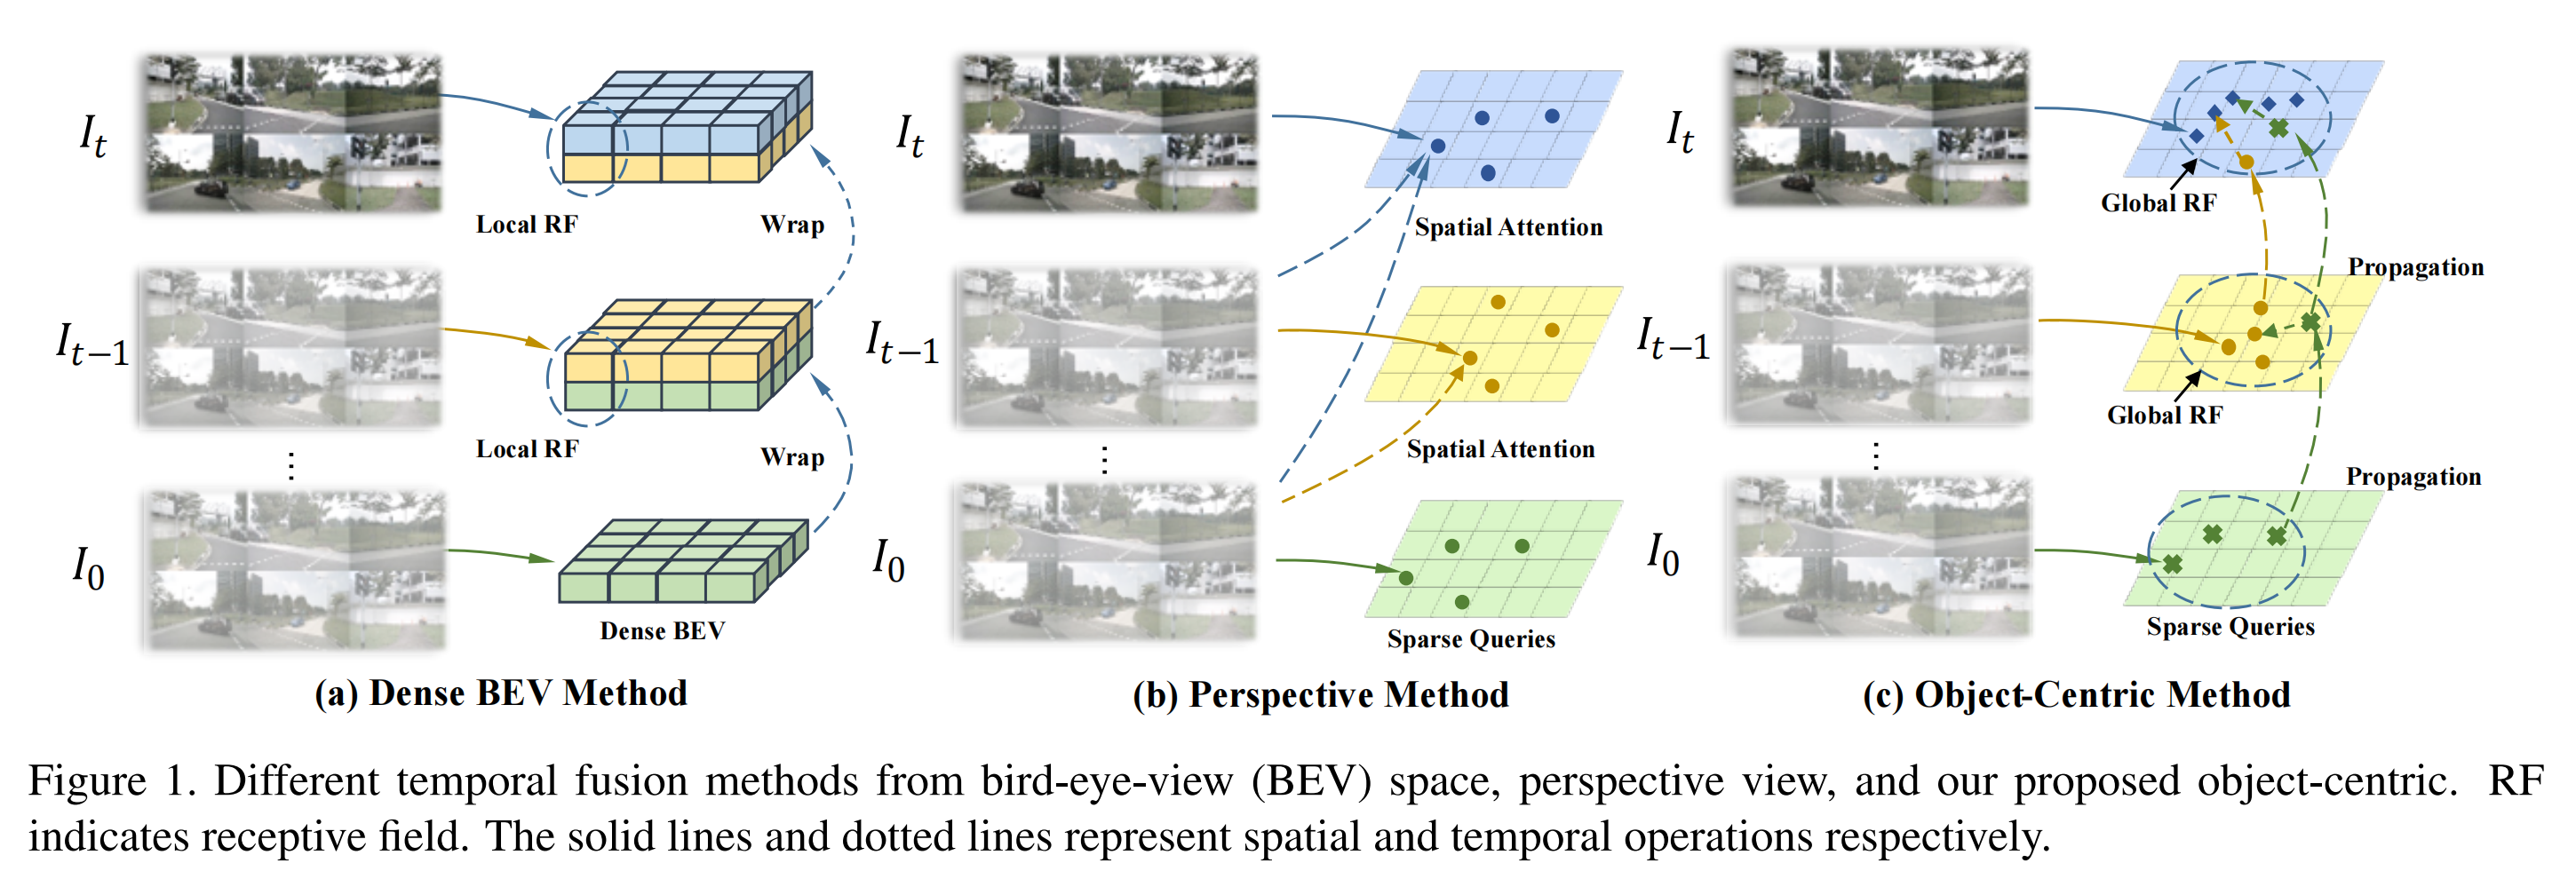
多视图目标检测通过利用时序信息取得了显着的进展,历史特征有利于遮挡物体的检测并大大提高性能。根据时序表示的差异,现有方法可以大致分为BEV时序方法和透视时序方法。
- BEV 时序方法
显式地将 BEV 特征从历史帧扭曲到当前帧,如图 1(a) 所示,其中 BEV 特征充当时序建模的有效中间表示。然而,高度结构化的 BEV 特征限制了移动物体的建模。这种范式需要一个大的感受野来缓解这个问题。
- 透视时序方法
主要基于 DETR 。稀疏查询设计有利于移动目标的建模。然而,sparse object querie需要与多帧图像特征交互以实现长期时序依赖性(见图 1(b) ),从而导致多次计算。因此,现有的工作要么停留在解决移动物体上,要么引入多重计算成本。
基于上述分析,本文采用稀疏查询作为时序传播的隐藏状态。利用object query来对移动目标进行建模,同时保持高效率。因此设计了一个高效的框架,以目标为中心的时序建模,称为StreamPETR,如图 1(c) 所示。
2. Related Work
2.1 Query Propagation
自 DETR 在 2D 目标检测中提出以来,object query已应用于许多下游任务来建模时序交互。
video object detection:
- LWDN 采用类脑记忆机制来传播和更新记忆特征。
- QueryProp 执行查询交互以减少非关键帧的计算成本,实现了显着的改进并保持了高效率。
- 3D-MAN 有类似的想法,并将单帧激光雷达探测器扩展到多帧,有效地结合了来自场景不同视角的特征。
object tracking:
- MOTR 和 TrackFormer 提出了跟踪查询来对跨帧的目标关联进行建模。
- MeMOT 使用内存库来构建长期依赖性,从而进一步提高性能。
- MOTRv2 通过合并一个额外的检测器来缓解检测和关联任务之间的冲突。
- MUTR 和 PF-Track 将 MOTR 扩展到多视图 3D 目标跟踪并取得了有希望的结果。
2.2 Delving into Temporal Modeling
本文提出了各种时序建模设计的通用公式。
- 给定透视图特征
- 密集 BEV 特征
- 稀疏目标特征
主要的时序建模方法可以表述为:
其中
2.2.1 BEV Temporal Modeling
BEV 时序建模使用网格结构的 BEV 特征来执行时序融合。为了补偿自车运动,最后一帧特征
然后时序融合函数
另一方面,长期历史信息通过 BEV 特征
然而,BEV时序融合仅考虑静态BEV特征,忽略了物体的运动,导致空间错位。
2.2.2 Perspective Temporal Modeling
透视时序建模主要通过object query和透视特征之间的交互来执行。时序函数
object query和多帧透视图之间的交叉注意力需要重复的特征聚合,简单地扩展到长期时序建模会大大增加计算成本。
2.2.3 Object-centric Temporal Modeling
以目标为中心的时序建模是本文提出的以目标为中心的解决方案,通过object query对时序交互进行建模。通过object query,可以基于估计状态
其中
3. Method
3.1 Overall Architecture
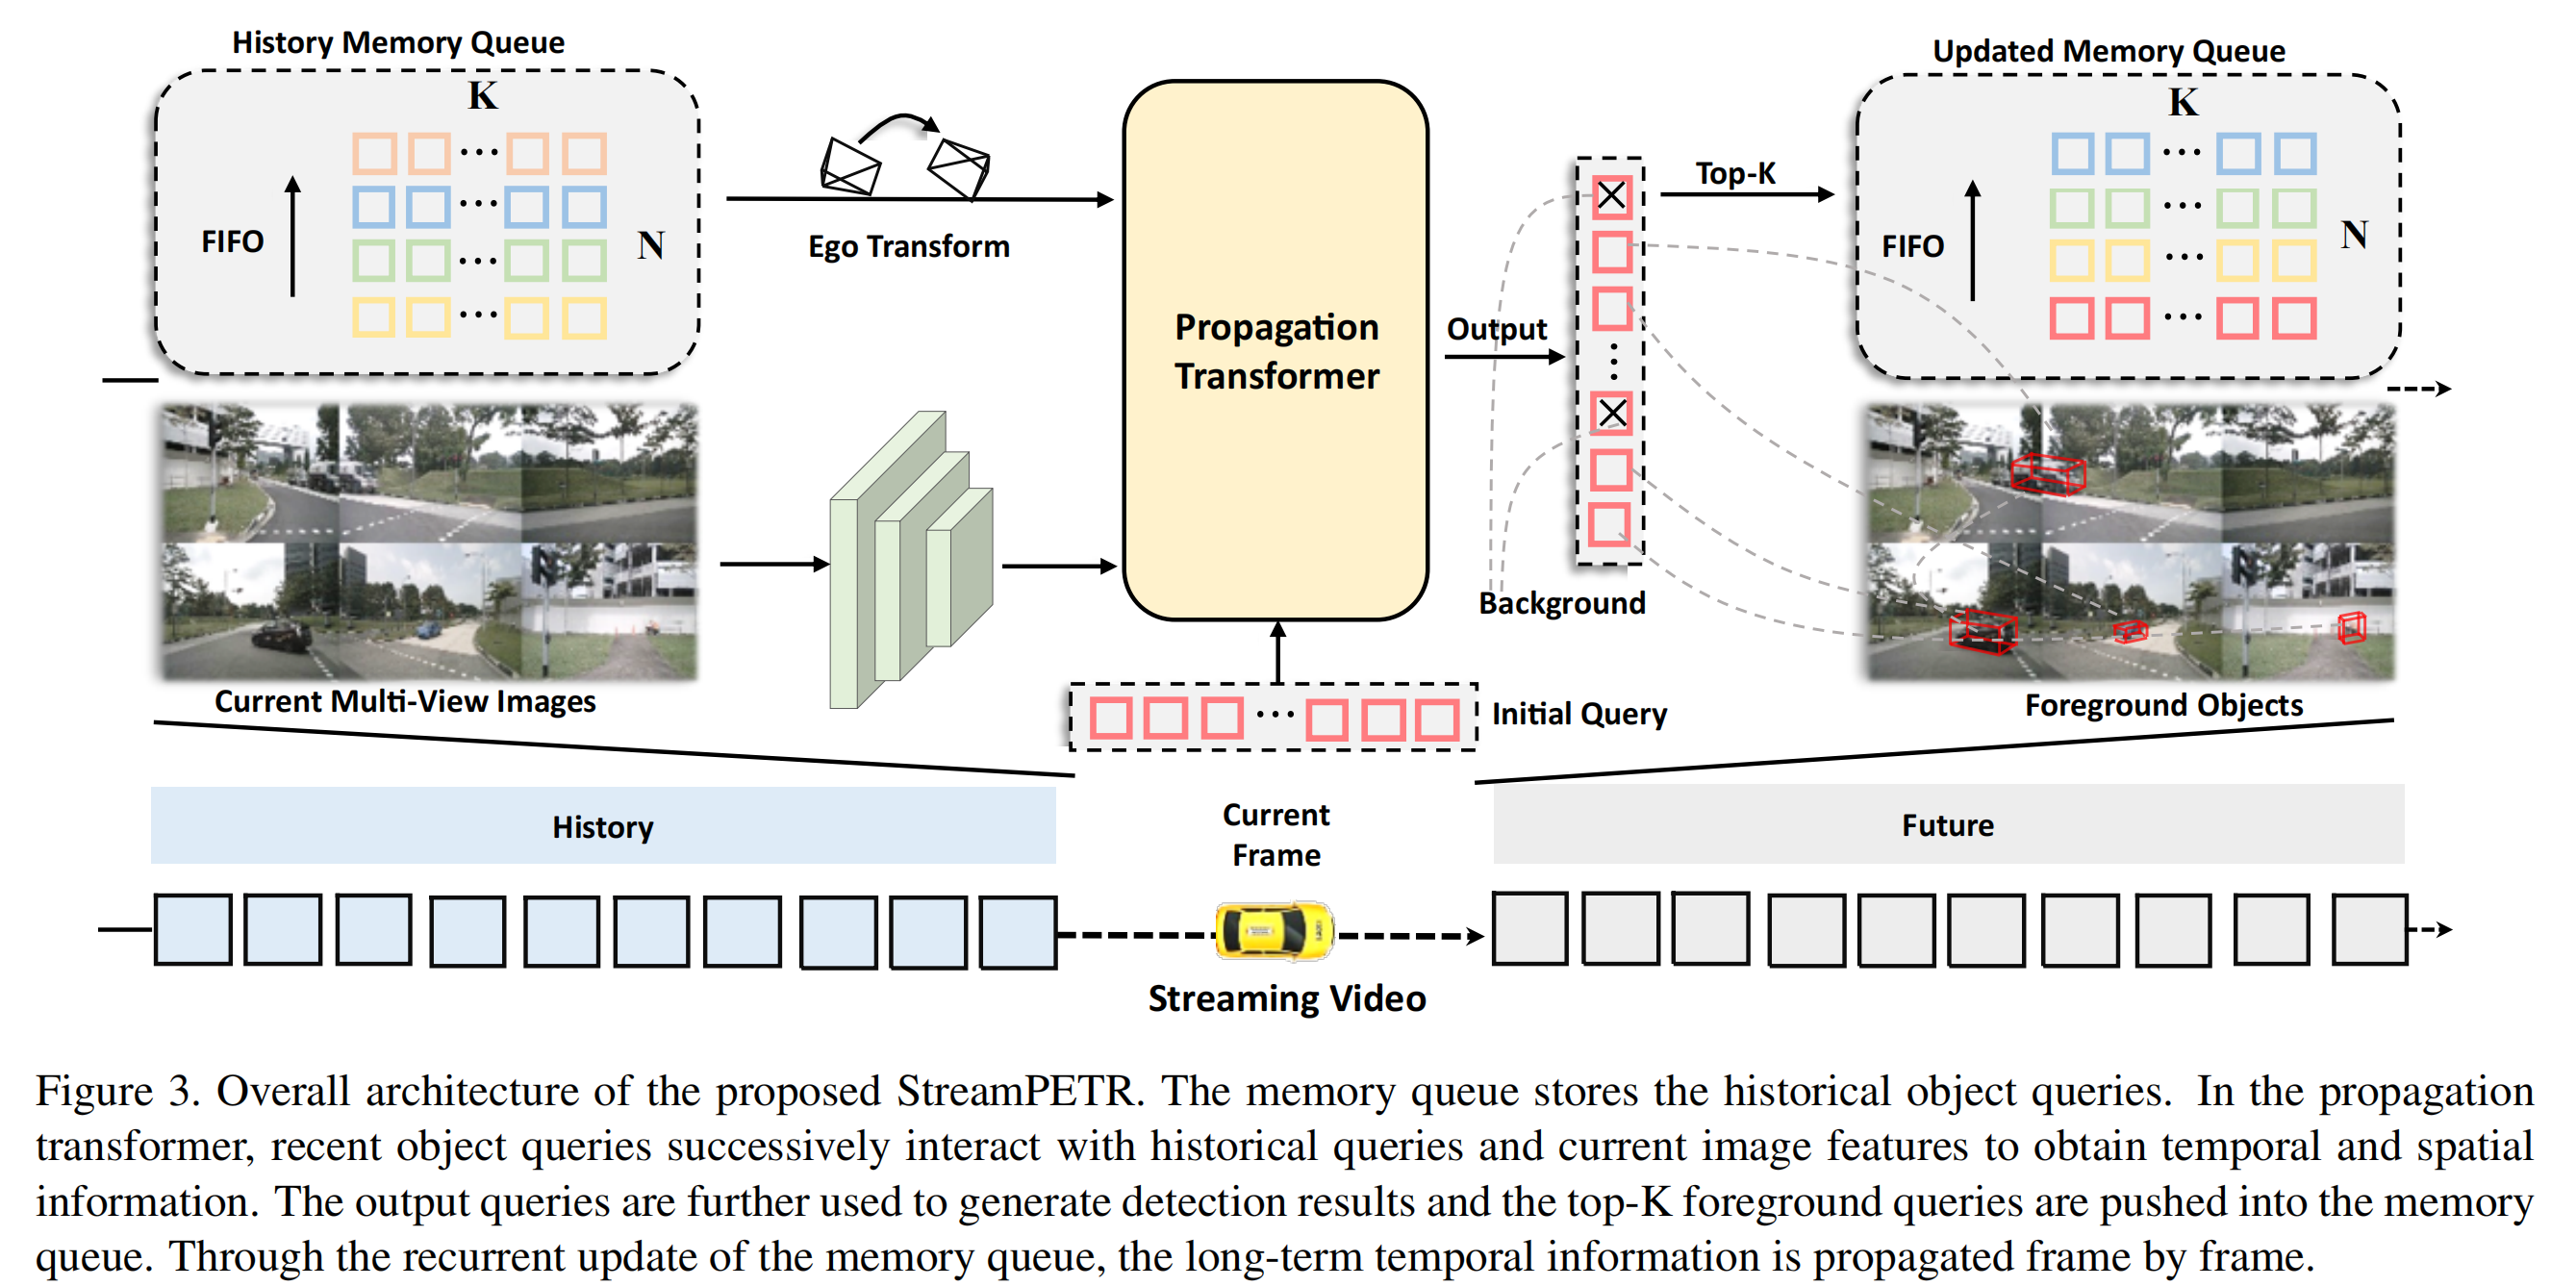
如图 3 所示,StreamPETR 构建在基于端到端稀疏查询的 3D 目标检测器之上。由图像编码器、递归更新的内存队列和传播transformer组成。图像编码器是标准的2D骨干网络,用于从多视图图像中提取语义特征。然后将提取的特征、内存队列中的信息和object query输入到传播transformer中以执行时空交互。 StreamPETR 和单帧基线的主要区别在于内存队列,可以递归地更新object query的时序信息。与传播transformer相结合,内存队列可以有效地将时序先验从先前帧传播到当前帧。
3.2 Memory Queue
本文设计了一个尺寸为
在预设的时间间隔
这个内存队列具有高度的灵活性和定制性,可以在训练和推理过程中自由控制最大内存大小
3.3 Propagation Transformer
如图4所示,传播transformer由三个主要组件:
- 运动感知层归一化模块根据上下文嵌入(embedding)和内存队列中记录的运动信息隐式更新目标状态;
- 混合注意力取代了默认的自注意力操作,起到时序建模和去除重复预测的作用;
- 采用交叉注意力进行特征聚合,可以替换为任意空间操作来构建图像标记和 3D object query之间的关系,例如 PETR 中的全局注意力或 DETR3D 中的稀疏投影注意力。
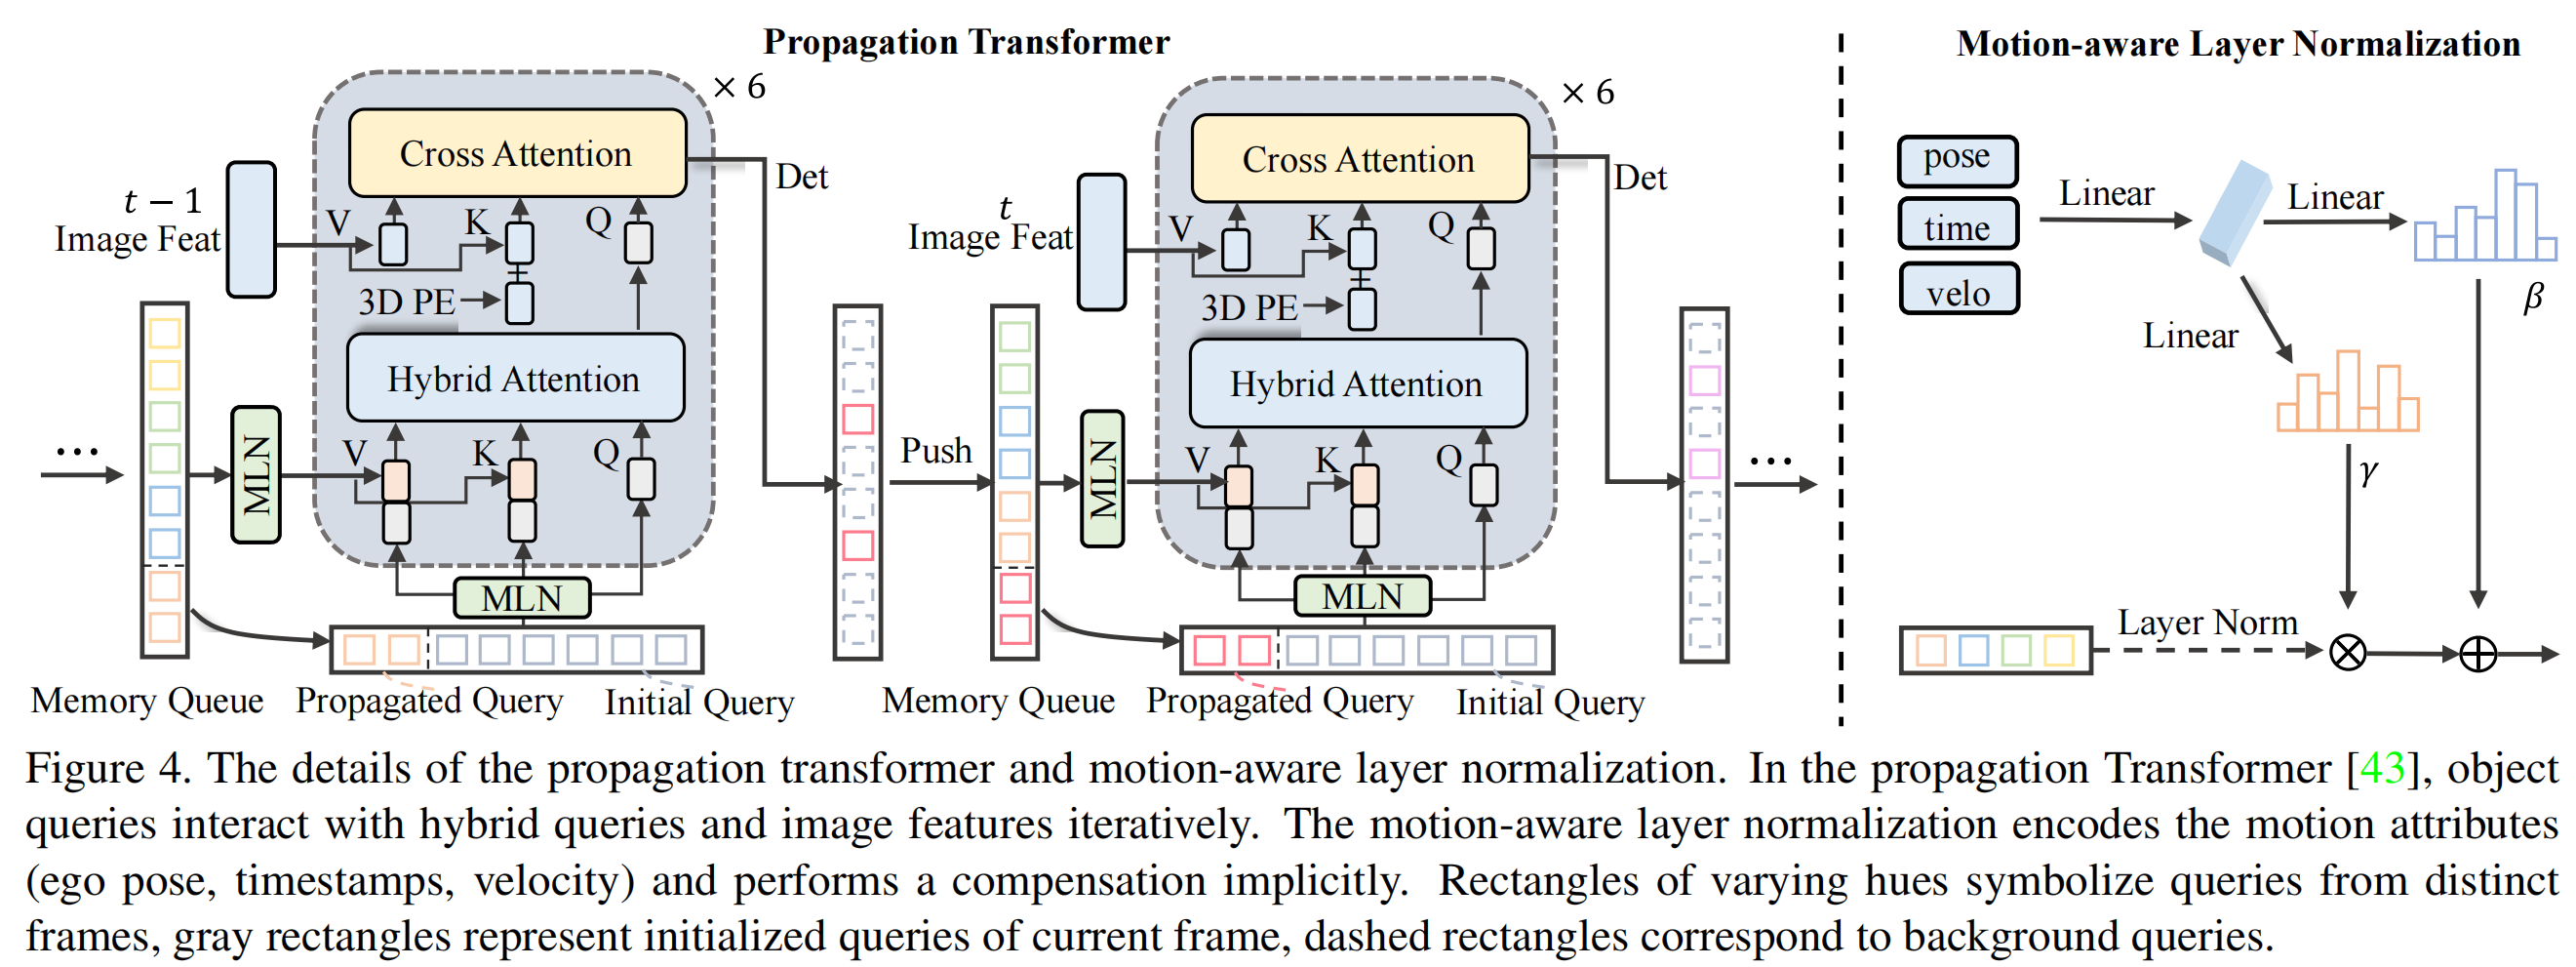
3.3.1 Motion-aware Layer Normalization
此模块以运动的目标进行建模。以最后一帧
假设目标是静态的,内存队列中的 3D 中心
其中
然后,执行仿射变换以获得运动感知上下文嵌入
其中,
3.3.2 Hybrid Attention layer
DETR 中的自注意力有助于消除重复的预测。本文用混合注意力取代它,还引入了时序交互。如图4所示,内存队列中所有存储的object query 与当前 query 连接以获得混合查询。混合查询被视为多头注意力中的关键。由于混合查询的数量很少(大约2k,远小于交叉注意力中的图像标记),因此混合注意力层带来的计算成本可以忽略不计。
遵循了 PETR,query 可以定义为随机初始化的 3D 锚点。为了充分利用流视频中的空间和上下文先验,内存队列中的一些object query被直接传播到当前帧中。本文将最后一帧的查询与随机初始化的查询连接在一起。为了公平比较,随机初始化查询和传播查询的数量分别设置为 644 和 256。
4. Conclusion
本文提出了 StreamPETR,一种有效的长序列 3D 物体检测器。与以前的工作不同,该方法探索了一种以目标为中心的范例,通过 object query 逐帧传播时间信息。此外,采用运动感知层归一化来引入运动信息。 StreamPETR 实现了领先的性能改进,同时引入的存储和计算成本可以忽略不计。它是第一个可与基于激光雷达的方法实现可比性能的在线多视图方法。